

Crawl là gì? Cách crawl dữ liệu trên website hiệu quả
Khi cần thu thập hàng nghìn thông tin từ website, việc truy cập và sao chép từng trang theo cách thủ công không chỉ mất thời gian mà còn dễ phát sinh sai sót. Đây chính là lúc công nghệ crawl phát huy vai trò, cho phép tự động truy cập, phân tích và thu thập dữ liệu từ nhiều trang web theo những tiêu chí được thiết lập sẵn. Vậy crawl là gì? Quá trình crawl dữ liệu website diễn ra như thế nào và đâu là những công cụ hỗ trợ hiệu quả? Cùng tìm hiểu chi tiết cách thức hoạt động, quy trình triển khai và những lưu ý quan trọng để khai thác dữ liệu website một cách chính xác, có hệ thống qua bài viết dưới đây.
Crawl là gì?
Crawl (web crawling) là quá trình sử dụng chương trình tự động để truy cập các trang web, đọc nội dung và lần theo những đường liên kết nhằm thu thập thông tin từ một hoặc nhiều website. Chương trình thực hiện hoạt động này được gọi là web crawler, spider hoặc bot, có khả năng xử lý hàng loạt URL theo những quy tắc được thiết lập trước.
Trong hoạt động quản lý và khai thác dữ liệu, crawl được sử dụng để thu thập thông tin từ website với số lượng lớn mà không cần truy cập thủ công từng trang. Chẳng hạn, bạn có thể crawl dữ liệu sản phẩm từ website thương mại điện tử, thu thập nội dung bài viết từ các trang tin tức hoặc lấy thông tin về giá bán, mô tả và danh mục sản phẩm từ nhiều nguồn khác nhau.
Website crawler hoạt động như thế nào?
Website crawler không thu thập dữ liệu một cách ngẫu nhiên mà hoạt động theo quy trình được thiết lập sẵn. Công cụ sẽ lần lượt tiếp nhận địa chỉ trang web, truy cập, phân tích nội dung và khám phá các liên kết liên quan để mở rộng phạm vi thu thập. Mỗi công đoạn đều có vai trò nhất định, giúp quá trình crawl dữ liệu diễn ra có hệ thống và đúng mục tiêu. Cụ thể như sau:
1. Tiếp nhận URL và xác định phạm vi crawl
Đầu tiên, crawler tiếp nhận danh sách URL ban đầu (seed URLs) do người dùng cung cấp hoặc lấy từ nguồn dữ liệu đã được xác định. Đây là điểm khởi đầu để chương trình khám phá các trang web cần thu thập thông tin.
Sau đó, hệ thống thiết lập phạm vi crawl dựa trên tên miền, thư mục, loại trang hoặc những điều kiện cụ thể. Chẳng hạn, nếu bạn muốn thu thập thông tin sản phẩm, crawler có thể được giới hạn trong các đường dẫn thuộc danh mục sản phẩm thay vì truy cập toàn bộ website.
2. Gửi yêu cầu truy cập đến website
Sau khi xác định URL, crawler gửi HTTP request đến máy chủ website để yêu cầu tài nguyên. Máy chủ sẽ phản hồi bằng nội dung trang web hoặc mã trạng thái HTTP tương ứng như 200 (thành công), 301 (chuyển hướng), 403 (bị từ chối truy cập) và 404 (không tìm thấy tài nguyên).
Trong quá trình này, crawler cần xử lý các phản hồi từ máy chủ, kiểm soát thời gian chờ và số lượng yêu cầu để tránh gây quá tải cho website. Một số hệ thống còn thiết lập user-agent để nhận diện chương trình đang thực hiện truy cập.
3. Tải và phân tích nội dung trang web
Khi nhận được phản hồi phù hợp, crawler tải nội dung trang về để phân tích. Với website sử dụng HTML tĩnh, chương trình có thể đọc trực tiếp mã nguồn HTML và xác định các thành phần như tiêu đề, đoạn văn, hình ảnh, bảng thông tin hoặc liên kết.
Đối với website sử dụng JavaScript để tải nội dung động, crawler có thể cần sử dụng trình duyệt tự động để thực thi mã và chờ nội dung hiển thị hoàn chỉnh. Việc này giúp chương trình tiếp cận những dữ liệu không xuất hiện đầy đủ trong HTML ban đầu.
4. Trích xuất thông tin và tìm kiếm liên kết mới
Sau khi phân tích cấu trúc trang, crawler xác định những thông tin cần thu thập dựa trên bộ quy tắc đã thiết lập. Các dữ liệu có thể bao gồm tiêu đề, nội dung bài viết, giá sản phẩm, hình ảnh, đường dẫn và những thuộc tính HTML liên quan.
Đồng thời, chương trình tìm kiếm các thẻ liên kết như < a href="..." > để phát hiện URL mới. Những địa chỉ phù hợp sẽ được đưa vào hàng đợi (URL queue) và tiếp tục xử lý theo phạm vi crawl đã xác định.
5. Lưu trữ dữ liệu thu thập được
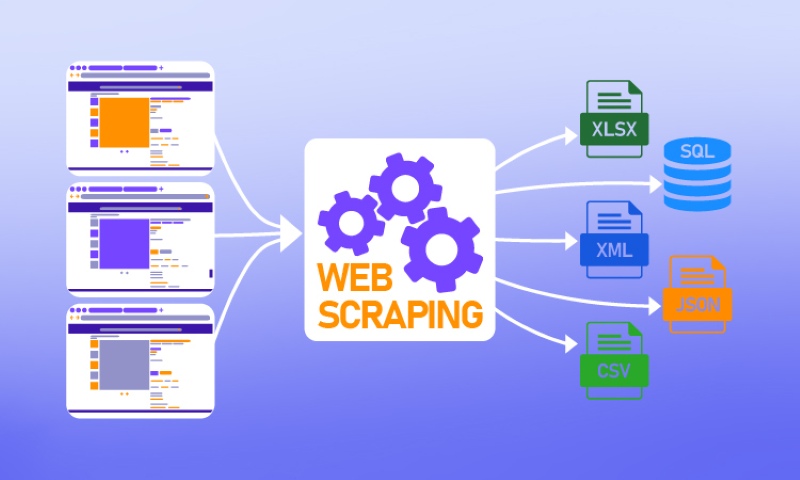
Sau khi hoàn tất quá trình trích xuất, dữ liệu được lưu vào hệ thống để phục vụ những hoạt động tiếp theo. Tùy theo quy mô và mục đích sử dụng, bạn có thể lưu kết quả dưới dạng CSV, JSON, Excel hoặc đưa vào cơ sở dữ liệu như MySQL, PostgreSQL và MongoDB.
Ở bước này, crawler thường cần kiểm tra URL trùng lặp, trạng thái thu thập, thời gian truy cập và chất lượng dữ liệu. Việc lưu trữ có cấu trúc giúp bạn dễ dàng tìm kiếm, cập nhật và khai thác thông tin sau khi crawl data.
Các loại dữ liệu có thể crawl trên website
Tùy thuộc vào mục tiêu thu thập và cấu trúc của từng website, crawler có thể tiếp cận nhiều nhóm thông tin khác nhau. Mỗi loại dữ liệu phục vụ một mục đích riêng, từ nghiên cứu nội dung, phân tích thị trường đến kiểm tra và tối ưu SEO. Dưới đây là những nhóm dữ liệu phổ biến có thể thu thập từ website.
- Dữ liệu văn bản và nội dung bài viết: Đây là nhóm dữ liệu thường được thu thập từ website tin tức, blog, diễn đàn và các trang chia sẻ kiến thức. Crawler có thể trích xuất tiêu đề, nội dung bài viết, các thẻ heading, ngày đăng, tên tác giả và chuyên mục. Những thông tin này hỗ trợ phân loại chủ đề, nghiên cứu nội dung và theo dõi xu hướng thông tin trên website.
- Dữ liệu sản phẩm và giá bán: Các website thương mại điện tử thường chứa nhiều thông tin về sản phẩm được phân chia theo danh mục, thương hiệu và mức giá. Khi crawl data website, crawler có thể thu thập tên sản phẩm, mã hàng, giá niêm yết, giá khuyến mãi, mô tả, thông số kỹ thuật và tình trạng hàng hóa được công khai. Bạn có thể sử dụng nguồn dữ liệu này để so sánh giá, theo dõi đối thủ và nghiên cứu thị trường.
- Dữ liệu hình ảnh và đường dẫn media: Ngoài văn bản, crawler còn có thể thu thập thông tin về hình ảnh, video và các tài nguyên đa phương tiện được sử dụng trên website. Những dữ liệu phổ biến gồm URL hình ảnh, đường dẫn video, tên file, định dạng, thuộc tính ALT và liên kết đến tài liệu công khai như PDF. Nhóm thông tin này hỗ trợ quản lý tài nguyên, kiểm tra liên kết media và phân tích nội dung trực quan.
- Dữ liệu liên kết và cấu trúc website: Trong quá trình crawl, crawler có thể ghi nhận URL của từng trang, liên kết nội bộ, liên kết ngoài, anchor text và mã trạng thái HTTP. Những thông tin này phản ánh cách các trang được kết nối và tổ chức trên website. Qua đó, bạn có thể kiểm tra cấu trúc điều hướng, phát hiện liên kết hỏng, trang mồ côi và những vấn đề ảnh hưởng đến khả năng thu thập dữ liệu.
- Dữ liệu metadata và thông tin SEO: Đây là nhóm thông tin mô tả nội dung và đặc điểm kỹ thuật của từng trang, thường được sử dụng trong quá trình kiểm tra SEO website. Crawler có thể thu thập thẻ title, meta description, meta robots, canonical, open graph, heading và dữ liệu có cấu trúc (structured data). Từ những thông tin này, bạn có thể phát hiện trang thiếu metadata, trùng lặp tiêu đề hoặc gặp vấn đề về cấu hình SEO.
Phân biệt crawl dữ liệu, web scraping và indexing
Crawl dữ liệu, web scraping và indexing là ba khái niệm có liên quan đến quá trình thu thập và xử lý thông tin trên Internet. Mặc dù thường xuất hiện cùng nhau nhưng mỗi hoạt động lại đảm nhận một nhiệm vụ riêng.
|
Tiêu chí |
Crawl dữ liệu |
Web scraping |
Indexing |
|
Mục đích |
Khám phá URL và thu thập nội dung từ các trang web. |
Lấy dữ liệu có cấu trúc theo những trường thông tin xác định. |
Tổ chức dữ liệu để có thể tìm kiếm và truy xuất nhanh chóng. |
|
Cách hoạt động |
Truy cập URL, tải trang và lần theo liên kết. |
Phân tích HTML, DOM hoặc dữ liệu trả về để lấy trường thông tin cần thiết. |
Phân tích nội dung, tạo chỉ mục và lưu trữ theo cấu trúc phù hợp. |
|
Đầu ra |
Danh sách URL, nội dung trang và tài nguyên được thu thập. |
Dữ liệu đã được trích xuất dưới dạng bảng, JSON hoặc cấu trúc khác. |
Bộ chỉ mục phục vụ tìm kiếm và truy vấn. |
|
Công cụ phổ biến |
Scrapy, crawler tùy chỉnh, trình thu thập của công cụ tìm kiếm. |
Beautiful Soup, Scrapy, Octoparse, Playwright. |
Elasticsearch, Apache Solr hoặc hệ thống indexing của công cụ tìm kiếm. |
|
Ứng dụng |
Khám phá website, thu thập nội dung, kiểm tra cấu trúc trang. |
Thu thập giá sản phẩm, nội dung bài viết và thông tin thị trường. |
Tìm kiếm nội dung, truy xuất dữ liệu và xây dựng hệ thống tra cứu. |
Quy trình crawl data website cơ bản
Để thu thập dữ liệu website chính xác và phục vụ đúng mục đích, bạn cần xác định rõ phạm vi, lựa chọn công cụ và thiết lập phương pháp triển khai phù hợp. Một quy trình crawl data website thường gồm các bước cơ bản sau:
Bước 1: Xác định mục tiêu và dữ liệu cần thu thập
Trước khi bắt đầu, bạn cần xác định rõ mục đích sử dụng dữ liệu và những thông tin cần lấy từ website. Việc xác định đúng mục tiêu giúp bạn lựa chọn phương pháp crawl phù hợp, tránh thu thập quá nhiều dữ liệu không cần thiết và giảm thời gian xử lý.
Chẳng hạn, nếu muốn phân tích giá bán trên thị trường, bạn chỉ cần tập trung vào tên sản phẩm, giá, thương hiệu và tình trạng hàng hóa được công khai. Nếu mục tiêu là kiểm tra SEO, những trường như URL, title, meta description, heading, canonical và mã trạng thái HTTP sẽ quan trọng hơn.
Bước 2: Lựa chọn website và phạm vi crawl
Sau khi xác định mục tiêu, bạn cần lựa chọn nguồn dữ liệu phù hợp và thiết lập phạm vi truy cập. Các tiêu chí nên xem xét bao gồm mức độ liên quan của nội dung, cấu trúc website, khả năng truy cập, độ ổn định và điều khoản sử dụng dữ liệu.
Tiếp theo, hãy xác định những URL hoặc danh mục cần thu thập, số lượng trang dự kiến và giới hạn độ sâu liên kết (crawl depth). Ví dụ, bạn có thể chỉ thu thập các trang thuộc thư mục /san-pham/ thay vì crawl toàn bộ website.
Bước 3: Chọn công cụ hoặc xây dựng website crawler
Tùy vào quy mô dự án và kiến thức lập trình, bạn có thể sử dụng công cụ crawl data website có sẵn hoặc tự xây dựng crawler. Nếu không có nhiều kinh nghiệm lập trình, các nền tảng như Octoparse, ParseHub và Browse AI cung cấp giao diện trực quan, giúp thiết lập quy trình thu thập dữ liệu dễ dàng hơn.
Đối với dự án cần tùy chỉnh sâu, bạn có thể sử dụng Scrapy, Python, Playwright hoặc Puppeteer để xây dựng crawler theo yêu cầu. Khi lựa chọn công cụ, cần xem xét khả năng xử lý JavaScript, quản lý URL, xuất dữ liệu, kiểm soát tốc độ truy cập và xử lý lỗi. Nên thử nghiệm trên một số trang trước khi triển khai rộng để đánh giá độ chính xác.
Bước 4: Thiết lập quy tắc crawl và trích xuất dữ liệu
Ở bước này, bạn cần xây dựng những quy tắc giúp crawler biết trang nào được phép truy cập, thông tin nào cần thu thập và cách xử lý nội dung nhận được. Một số thiết lập quan trọng gồm:
- Quy tắc URL: Xác định mẫu đường dẫn cần crawl, loại URL cần bỏ qua và cách xử lý tham số truy vấn.
- Bộ chọn dữ liệu: Sử dụng CSS Selector, XPath hoặc phương pháp phân tích DOM để xác định vị trí thông tin cần lấy.
- Giới hạn truy cập: Thiết lập thời gian chờ, số lượng yêu cầu đồng thời và khoảng nghỉ giữa các lần truy cập.
- Quản lý liên kết: Loại bỏ URL trùng lặp và kiểm soát độ sâu khi lần theo các liên kết.
- Xử lý nội dung động: Sử dụng trình duyệt tự động nếu website cần thực thi JavaScript để hiển thị dữ liệu.
Bước 5: Làm sạch, chuẩn hóa và lưu trữ dữ liệu
Dữ liệu sau khi crawl có thể tồn tại những vấn đề như trùng lặp, thiếu trường thông tin, sai định dạng hoặc chứa các thành phần không cần thiết. Vì vậy, bạn cần thực hiện bước làm sạch và chuẩn hóa trước khi đưa vào hệ thống lưu trữ.
Một số công việc nên thực hiện gồm:
- Loại bỏ bản ghi trùng lặp dựa trên URL hoặc mã định danh.
- Chuẩn hóa định dạng ngày tháng, giá tiền và văn bản.
- Xử lý khoảng trắng, ký tự đặc biệt và HTML không cần thiết.
- Kiểm tra những trường dữ liệu bị thiếu hoặc không hợp lệ.
- Phân loại thông tin theo danh mục và cấu trúc thống nhất.
Sau khi xử lý, bạn có thể lưu dữ liệu dưới dạng CSV, JSON, Excel hoặc sử dụng hệ quản trị cơ sở dữ liệu tùy theo quy mô dự án. Việc lưu trữ khoa học giúp quá trình truy vấn, phân tích và cập nhật dữ liệu về sau thuận tiện hơn.
Bước 6: Kiểm tra và cập nhật dữ liệu định kỳ
Sau khi hoàn tất quá trình thu thập, bạn cần kiểm tra chất lượng dữ liệu và đánh giá mức độ đáp ứng mục tiêu ban đầu. Những yếu tố cần theo dõi gồm số lượng URL đã truy cập, tỷ lệ thu thập thành công, trường thông tin bị thiếu, dữ liệu trùng lặp và các lỗi phát sinh.
Đối với những website thường xuyên cập nhật nội dung, bạn nên thiết lập lịch crawl định kỳ thay vì thu thập lại toàn bộ dữ liệu mỗi lần. Crawler có thể ưu tiên những URL mới, trang có nội dung thay đổi hoặc dữ liệu đã đến thời điểm cần cập nhật.
Ngoài ra, việc ghi nhật ký hoạt động (log), theo dõi mã trạng thái HTTP và kiểm tra những thay đổi trong cấu trúc HTML giúp bạn phát hiện sớm lỗi website crawler. Nhờ đó, hệ thống crawl data website có thể duy trì hoạt động ổn định và hạn chế tình trạng dữ liệu lỗi thời.
Các công cụ crawl dữ liệu website phổ biến
Để crawl dữ liệu trên website, bạn có thể lựa chọn nhiều công cụ khác nhau tùy theo nhu cầu và mức độ phức tạp của dự án. Một số nền tảng cho phép thu thập thông tin trực tiếp qua giao diện mà không cần viết code, trong khi những công cụ khác cung cấp khả năng tùy chỉnh sâu thông qua lập trình.
1. Công cụ crawl dữ liệu không cần code
Đây là nhóm công cụ phù hợp với người mới bắt đầu hoặc doanh nghiệp muốn thu thập dữ liệu mà không cần tự xây dựng chương trình. Người dùng có thể thiết lập quy tắc lấy thông tin thông qua giao diện trực quan và tự động hóa nhiều thao tác.
- Octoparse: Octoparse là công cụ web scraping có giao diện trực quan, cho phép người dùng thiết lập quy trình thu thập dữ liệu mà không cần viết code. Công cụ hỗ trợ lấy thông tin sản phẩm, giá bán, nội dung bài viết và dữ liệu từ các website có cấu trúc phù hợp. Ngoài ra, Octoparse còn hỗ trợ phân trang và xuất dữ liệu dưới nhiều định dạng.
- ParseHub: ParseHub là công cụ trích xuất dữ liệu website thông qua giao diện đồ họa, cho phép người dùng lựa chọn trực tiếp những thành phần cần thu thập. Nền tảng hỗ trợ xử lý trang có nội dung động, thiết lập quy tắc điều hướng và lấy dữ liệu từ nhiều URL. Đây là lựa chọn phù hợp khi cần crawl website có cấu trúc phức tạp mà không muốn tự lập trình.
- Browse AI: Browse AI là nền tảng tự động hóa thu thập dữ liệu website thông qua các robot được cấu hình sẵn theo nhu cầu. Người dùng có thể hướng dẫn robot nhận diện thông tin cần lấy mà không phải tự xây dựng crawler bằng code. Công cụ còn hỗ trợ theo dõi những thay đổi trên website và tích hợp dữ liệu với các hệ thống được hỗ trợ.
- Web Scraper: Web Scraper là tiện ích mở rộng trên trình duyệt Chrome, hỗ trợ thu thập dữ liệu bằng cách thiết lập sitemap và các bộ chọn CSS Selector. Công cụ cho phép xác định thành phần cần lấy, cấu hình phân trang và điều hướng giữa các trang. Người dùng có thể sử dụng nền tảng này để crawl dữ liệu từ những website có cấu trúc tương đối rõ ràng.
2. Công cụ crawl dữ liệu dành cho lập trình viên
Nhóm công cụ này phù hợp với người có kiến thức lập trình và cần kiểm soát sâu quá trình truy cập, phân tích, trích xuất dữ liệu. Tùy vào ngôn ngữ và yêu cầu dự án, bạn có thể sử dụng framework hoặc kết hợp nhiều thư viện để xây dựng crawler riêng.
- Scrapy: Scrapy là framework mã nguồn mở được phát triển bằng Python, chuyên dùng để xây dựng crawler và thu thập dữ liệu website. Công cụ cung cấp các thành phần quản lý request, response, điều hướng URL và xử lý dữ liệu thông qua Item Pipeline. Scrapy phù hợp với những dự án crawl nhiều trang và cần tổ chức quy trình thu thập dữ liệu có hệ thống.
- Beautiful Soup: Beautiful Soup là thư viện Python hỗ trợ phân tích tài liệu HTML và XML, giúp tìm kiếm và trích xuất thông tin từ cấu trúc trang web. Công cụ có thể lấy văn bản, liên kết và các thành phần HTML thông qua thẻ, thuộc tính hoặc CSS Selector. Beautiful Soup thường được kết hợp với Requests để gửi yêu cầu truy cập và thu thập dữ liệu website.
- Selenium: Selenium là bộ công cụ tự động hóa trình duyệt, cho phép lập trình viên điều khiển trình duyệt và tương tác với các thành phần trên website. Trong hoạt động crawl, Selenium hỗ trợ truy cập trang, thực hiện thao tác và lấy nội dung sau khi JavaScript được thực thi. Công cụ phù hợp với những website cần tương tác như nhấn nút, điền biểu mẫu hoặc cuộn trang để hiển thị dữ liệu.
- Puppeteer: Puppeteer là thư viện Node.js dùng để điều khiển trình duyệt Chrome hoặc Chromium thông qua giao thức DevTools Protocol. Công cụ hỗ trợ truy cập URL, tương tác với phần tử trên trang, lấy nội dung HTML sau khi kết xuất và theo dõi các yêu cầu mạng. Đây là lựa chọn phù hợp với lập trình viên sử dụng JavaScript hoặc Node.js để xây dựng crawler phục vụ thu thập dữ liệu website.
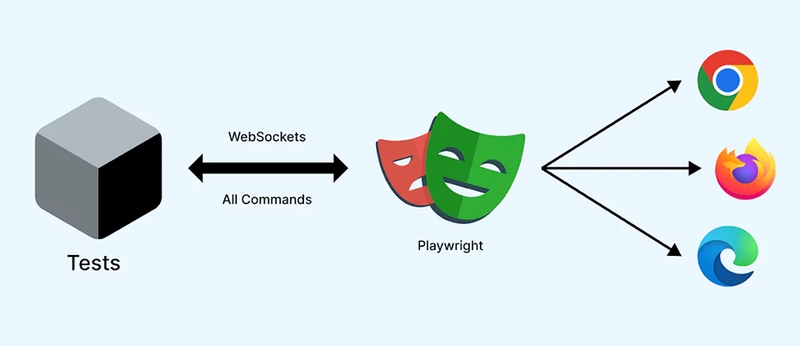
- Playwright: Playwright là framework tự động hóa trình duyệt, hỗ trợ Chromium, Firefox và WebKit. Công cụ cho phép điều khiển trình duyệt, tương tác với các thành phần DOM và thu thập nội dung được kết xuất từ website sử dụng JavaScript. Playwright phù hợp với dự án cần xử lý trang động, điều hướng phức tạp và kiểm soát các yêu cầu mạng.
Những lưu ý quan trọng khi crawl dữ liệu trên website
Crawl data website giúp tự động hóa quá trình thu thập thông tin, nhưng việc triển khai không đúng cách có thể gây ra lỗi truy cập, dữ liệu thiếu chính xác hoặc ảnh hưởng đến hoạt động của website nguồn. Vì vậy, bạn cần lưu ý một số vấn đề sau:
- Kiểm tra robots.txt và điều khoản sử dụng website: Trước khi crawl, hãy kiểm tra robots.txt để nắm các quy tắc truy cập dành cho crawler và đọc điều khoản sử dụng của website. Lưu ý, robots.txt không phải cơ chế phân quyền hay xác thực, URL không bị chặn không đồng nghĩa với việc bạn được tự do khai thác nội dung.
- Không gửi quá nhiều yêu cầu trong thời gian ngắn: Crawler truy cập liên tục có thể làm tăng tải máy chủ và ảnh hưởng đến trải nghiệm người dùng. Bạn nên giới hạn tốc độ request, số kết nối đồng thời và điều chỉnh tần suất truy cập khi nhận phản hồi như lỗi 429 (Too Many Requests).
- Xử lý các trang có nội dung tải bằng JavaScript: Một số website chỉ hiển thị đầy đủ thông tin sau khi JavaScript được thực thi. Nếu chỉ thu thập HTML ban đầu, crawler có thể bỏ sót dữ liệu. Trong trường hợp này, bạn có thể sử dụng Playwright, Selenium hoặc Puppeteer để hỗ trợ kết xuất nội dung trang.
- Kiểm tra dữ liệu trùng lặp và sai định dạng: Dữ liệu sau khi crawl có thể chứa bản ghi trùng lặp, thiếu thông tin hoặc không thống nhất về định dạng. Do đó, bạn cần kiểm tra, chuẩn hóa và loại bỏ những dữ liệu không hợp lệ trước khi lưu trữ để đảm bảo chất lượng thông tin.
- Tôn trọng bản quyền và quyền riêng tư dữ liệu: Không phải mọi nội dung công khai trên website đều được phép sao chép hoặc sử dụng cho mục đích thương mại. Bạn cần xem xét quyền sở hữu nội dung, điều khoản sử dụng và quy định về bảo vệ dữ liệu cá nhân trước khi thu thập, lưu trữ hoặc khai thác thông tin.
- Theo dõi lỗi và cập nhật crawler thường xuyên: Cấu trúc HTML, URL và cách tải nội dung của website có thể thay đổi theo thời gian, khiến crawler hoạt động không chính xác. Bạn nên theo dõi nhật ký hoạt động, kiểm tra kết quả thu thập và cập nhật quy tắc crawl khi cần thiết để duy trì tính ổn định.
Nắm rõ nguyên lý crawl là gì và cách website crawler hoạt động sẽ giúp bạn chủ động hơn trong việc thu thập, quản lý và khai thác dữ liệu từ các nguồn trực tuyến. Tùy vào mục tiêu và quy mô dự án, bạn có thể lựa chọn công cụ phù hợp để tự động hóa quá trình crawl dữ liệu, đồng thời đảm bảo chất lượng thông tin và tuân thủ các quy định truy cập. Với những kiến thức được Website Chuyên Nghiệp chia sẻ trong bài viết, bạn có thể từng bước xây dựng quy trình crawl data website hiệu quả, phục vụ nhu cầu phân tích, nghiên cứu thị trường và phát triển hoạt động kinh doanh.
Bài viết liên quan:
 Crawl budget là gì? Cách tối ưu crawl budget cho website
Scam là gì? Cách kiểm tra web scam nhanh chóng, chính xác
Dung lượng website là gì? Hướng dẫn kiểm tra & tối ưu hiệu quả
Tin tức khác | Xem tất cả



 Chat Skype